谷歌添加 TPU 8tx 和 TPU 8i Max 用于机密和长上下文 AI
谷歌宣布推出用于机密人工智能推理的 TPU 8tx 和用于长上下文代理的双芯片 TPU 8i Max。什么是新的,什么是今天的 GA,以及仍然缺少什么。
新闻报道

谷歌宣布了什么
11 月 9 日,谷歌在其第八代 TPU 系列中又增加了两个系统: TPU 8TX,为机密推理而构建,并且 TPU 8i 最大,一个用于很长上下文窗口的两芯片封装。谷歌高级副总裁兼人工智能和基础设施首席技术专家 Amin Vahdat 在一篇题为“ “我们最新的 TPU:8tx 和 8i Max,专为代理时代打造”。该公司写道:“这是我们第一次在一年内推出四种 TPU 系统。”
两者都不是新硅。 TPU 8tx 使用与 TPU 8t 相同的芯片,TPU 8t 是谷歌在 4 月份的 Cloud Next 上展示的训练芯片。 TPU 8i Max 是在一个封装上集成两颗 TPU 8i 芯片。改变的是主机、网络和它们周围的包装,每一次改变都针对企业买家不断遇到的问题:在不允许移动的数据上运行模型,以及具有巨大上下文的代理遇到的内存墙。
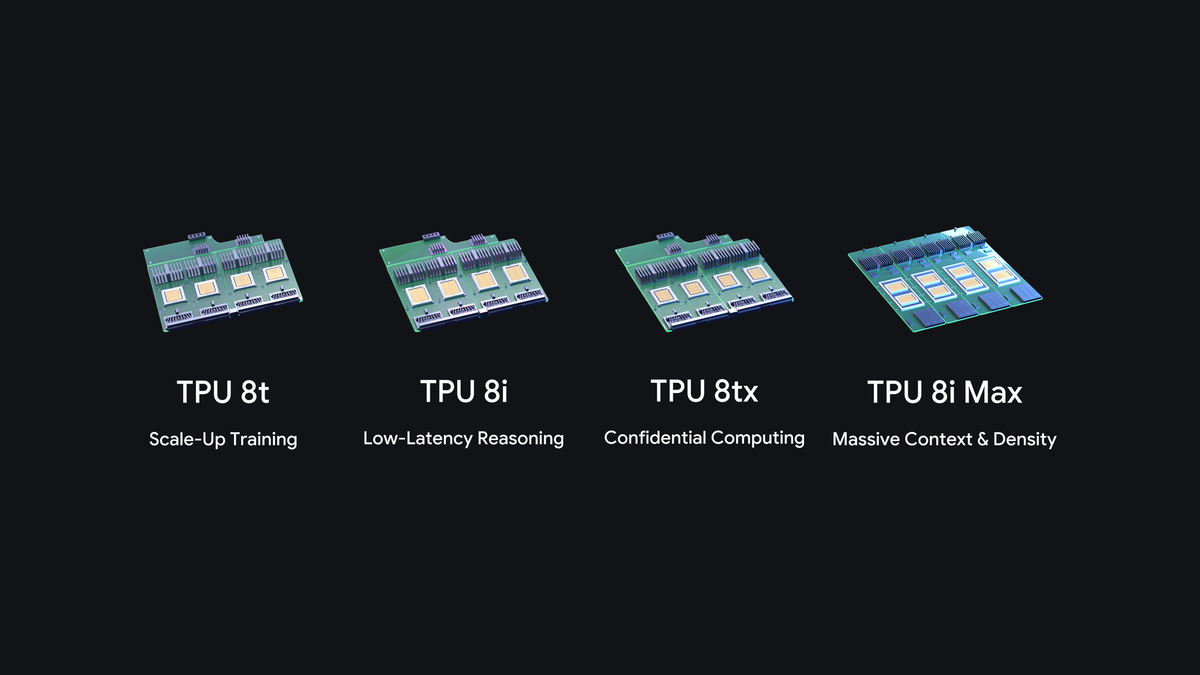
扩展的第八代产品阵容:TPU 8t、TPU 8i、TPU 8tx 和 TPU 8i Max。图片:谷歌。
谷歌自己对产品阵容的总结是:用于扩展训练的 TPU 8t、用于低延迟推理的 TPU 8i、用于机密计算的 TPU 8tx 以及用于“海量上下文窗口和每机架最高计算密度”的 TPU 8i Max。谷歌表示 TPU 目前拥有“近 100 个客户”。
TPU 8tx:TPU 8t 芯片上的机密计算
TPU 8tx 将 TPU 8t 芯片与第五代 AMD EPYC CPU 主机配对。根据 谷歌云的公告,它“将安全性直接构建到硬件层中,即使在活跃使用时也能保护和隔离敏感数据和模型权重。”最后一条是重点。对静态和传输中的数据进行加密是例行公事。在加速器上进行计算时保护它是机密计算所增加的功能,而在 Google Cloud 上,到目前为止这意味着 CPU 或 Nvidia GPU。 TPU 8tx 是谷歌以这种方式推出的第一个 TPU 系统。
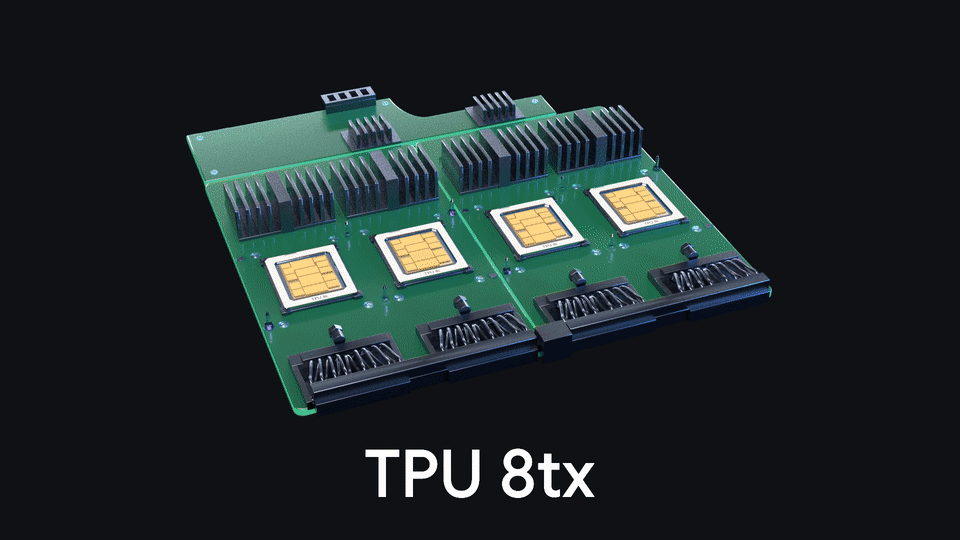
TPU 8tx,专为私有数据的硬件级机密计算而构建。图片:谷歌。
它借用了 Google 为 TPU 8i 构建的低延迟网络 Boardfly,谷歌声称在安全层“与 TPU 8t 相比,延迟降低了 2 倍,性能损失几乎为零”。目标客户是受监管的企业或政府,在其最敏感的数据旁边运行前沿或专有模型。谷歌表示,团队可以对私人数据进行微调,将大型模型分解为较小的模型,并通过强化学习来训练代理,“所有这些都不需要在不同集群之间迁移敏感数据”。
还有一个本地角度。谷歌云副总裁兼人工智能和计算基础设施总经理 Mark Lohmeyer 在新闻发布会上表示 数据中心知识报道 部分客户将能够在自己的数据中心部署 TPU 8tx。谷歌的博客只是更笼统地说,客户现在可以将 TPU 直接部署到自己的设施中。
TPU 8i Max:两颗芯片,一个封装
对于 TPU 8i Max,谷歌“采用了两个低延迟 TPU 8i 芯片,并将它们组合到一个封装中”,从而“使 TPU 8i 的计算量、SRAM 和 HBM 带宽加倍”。该宣传直接针对代理工作负载:“当数十个人工智能代理在整个软件代码库或几个小时的视频中同时工作时,内存带宽很快就会成为瓶颈。”洛迈耶称其为“在高速公路上增加更多车道”。
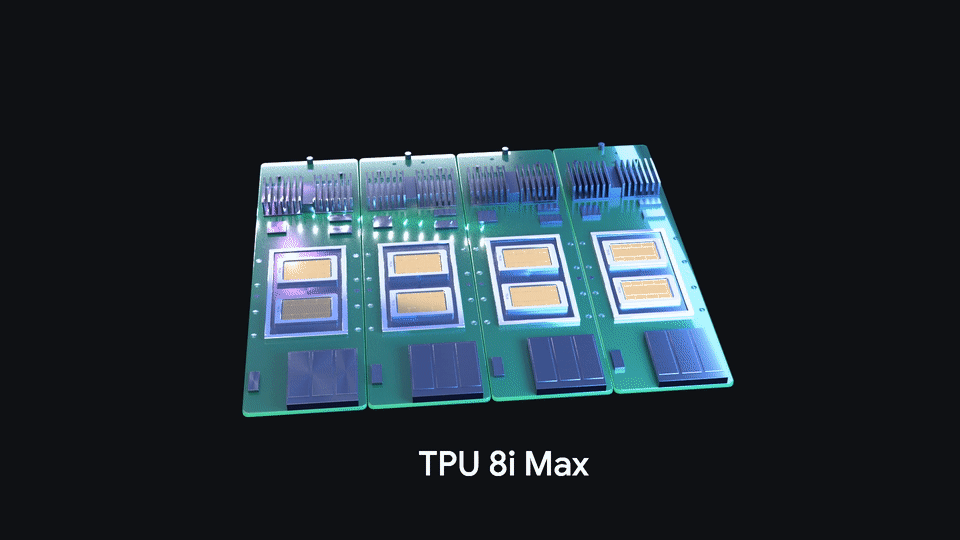
TPU 8i Max 旁边的标准 TPU 板,每个封装上放置两个 TPU 8i 芯片。图片:谷歌。
谷歌没有公布每个包的数据。将其“双”应用于 TPU 8i 4 月份的每芯片规格得出以下数字。将右侧列视为算术,而不是规格表。
| 每包 | TPU 8i(谷歌,四月) | TPU 8i Max(派生,2x) |
|---|---|---|
| 峰值 FP4 计算 | 10.1 PFLOP 数 | 约 20.2 PFLOP |
| 片上SRAM | 384MB | 约 768 MB |
| HBM 带宽 | 8,601 GB/秒 | 约 17.2TB/秒 |
| HBM容量 | 288GB | 谷歌没有说明 |
容量行故意留空。谷歌没有给出具体数字,而且一份新闻报道中的简报中给出的数字与两个 288 GB 芯片并不相符。在根据规格表确定模型尺寸之前,请先等待规格表。
另一个说法是密度。谷歌表示,由于 TPU 8i Max“在现有机架占地面积内安装了两倍的芯片”,因此运营商每平方英尺和每瓦特可以获得更多的计算能力。
附带的软件
目前还无法购买硬件,但部分软件现在可以使用。谷歌 开源 TPU 同步,它称之为“TPU 集群的模型状态层”。它将芯片 HBM、主机 DRAM、共享存储和网络视为一个内存层次结构,将大型 KV 缓存移出芯片,在单独的预填充和解码节点之间流式传输上下文,并同步强化学习权重。谷歌表示,它将 KV 传输延迟和第一个代币的时间缩短了 90% 以上。
Cloud Pathways 是 Gemini 背后的 Google DeepMind 运行时,现已在 GKE 上全面可用。 GKE 动态切片也是 GA:它使用光路交换来动态合并或分割 TPU 切片,Google 声称作业启动速度提高了 5 倍,故障恢复速度提高了 4.5 倍。 10 月,Google 开源了 TorchTPU,因此 PyTorch 代码和 Hugging Face 模型可以在 TPU 上本机运行,并具有用于 vLLM 和 SGLang 的 TPU 后端。
| 已公布 | 截至 2026 年 11 月 10 日的状况 |
|---|---|
| TPU 8tx、TPU 8i 最大 | 宣布;无价格、地区或上市日期 |
| GKE 上的云路径 | 一般可用 |
| GKE动态切片 | 一般可用 |
| TPU同步 | 开源 |
| XLA 服务引擎 | 开源;跨 TPU、GPU 和 CPU 提供服务 |
| TPU 代理套件(Claude Code、Cursor、Google Antigravity) | 预览 |
| 代理计算引擎 | 宣布;暂停和恢复空闲会话 |
谷歌还表示,其 vLLM-TorchTPU 堆栈在 InferenceX 和 AgentX 基准测试中发布了“最先进的性价比标记”,但没有提供任何数据。上面的每个乘数也是如此:它们是谷歌的数字,并且没有经过独立测试。
对于以此为基础的团队来说,它会带来什么变化
对于银行、医院集团或政府机构来说,TPU 8tx 值得关注。如今,一个需要在 Google Cloud 上进行硬件隔离推理的团队正在研究 CPU 或 Nvidia GPU 上的机密虚拟机。 TPU 8tx 可以让同一团队在一个独立的系统上进行微调、提炼和服务,也可能在自己的建筑中。 IDC 集团副总裁戴夫·麦卡锡 (Dave McCarthy) 直言不讳地说:“如果谷歌能够拿出一个强大的机密计算故事,这会给他们带来一点优势。”
对于长上下文和多智能体推理,瓶颈是内存,而不是数学。 TPU 8i Max 使每个封装的带宽加倍,并且 TPU Sync 在 KV 缓存不适合时将其移至片外。
对于 PyTorch 商店来说,从 Nvidia 的转换成本不断下降。 TorchTPU 加上 vLLM 和 SGLang 后端意味着团队可以尝试 TPU,而无需在 JAX 中重写模型。这才是英伟达面临的真正挑战,比任何单芯片都要大。
目前谁可以忽略这一点:本季度需要新产能的任何人,以及没有监管压力的 Nvidia 的任何人。这两个新系统都无法订购,并且公告中没有任何内容强制从正在运行的 CUDA 堆栈中迁移。
接下来是什么
Google 尚未公布 TPU 8tx 或 TPU 8i Max 的定价、区域或全面上市日期。其 4 月份的帖子称,TPU 8t 和 8i 将于 2026 年晚些时候全面上市,该公司将感兴趣的客户推荐给其 TPU 兴趣表。容量也可能不会一直是谷歌云独有的:甲骨文表示将向甲骨文云基础设施客户提供谷歌TPU。
谷歌表示,AlphaChip 和 Gemini 现在“在数小时而不是数周内”生产出芯片布局,并且正在将 TPU 带到陌生的地方,因为它的 阳光捕手计划卫星发射 显示。接下来要寻找的是 8tx 的价格表,因为这将显示机密推理是否需要额外费用。