Meta 发布 Muse Spark Open:可在两个 Mac Studio 上运行的 816B 开放式模型
Meta 发布了 Muse Spark Open,这是一个具有 1M 代币上下文的 816B 开放权重 MoE 模型。许可条款、Mac Studio 设置、与 Kimi K3 的基准测试以及托管价格。
新闻报道

Meta 发布了什么
10 月 15 日,Meta 将 Muse Spark Open 的权重放在 Hugging Face 上:这是一个专家混合模型,总共约有 8160 亿个参数,每个代币约有 420 亿个活跃参数。它与 Muse Spark 1.3 共享其基本模型,直到本周您只能通过 API 访问该模型。的 PyTorch 博客 称其为“迄今为止最有能力的美国开放重量模型”。
该架构,每 Hugging Face 的发布文章:62 层,每个 MoE 层有 256 个专家,每个 token 选取 8 个专家,具有 128 个查询头和 16 个 KV 头的分组查询注意力,以及最多 100 万个 token 的上下文窗口。它读取文本、图像、视频和音频并以文本形式回答。 1.8B 参数感知编码器处理图片和视频。音频每秒到达 12.5 个令牌。
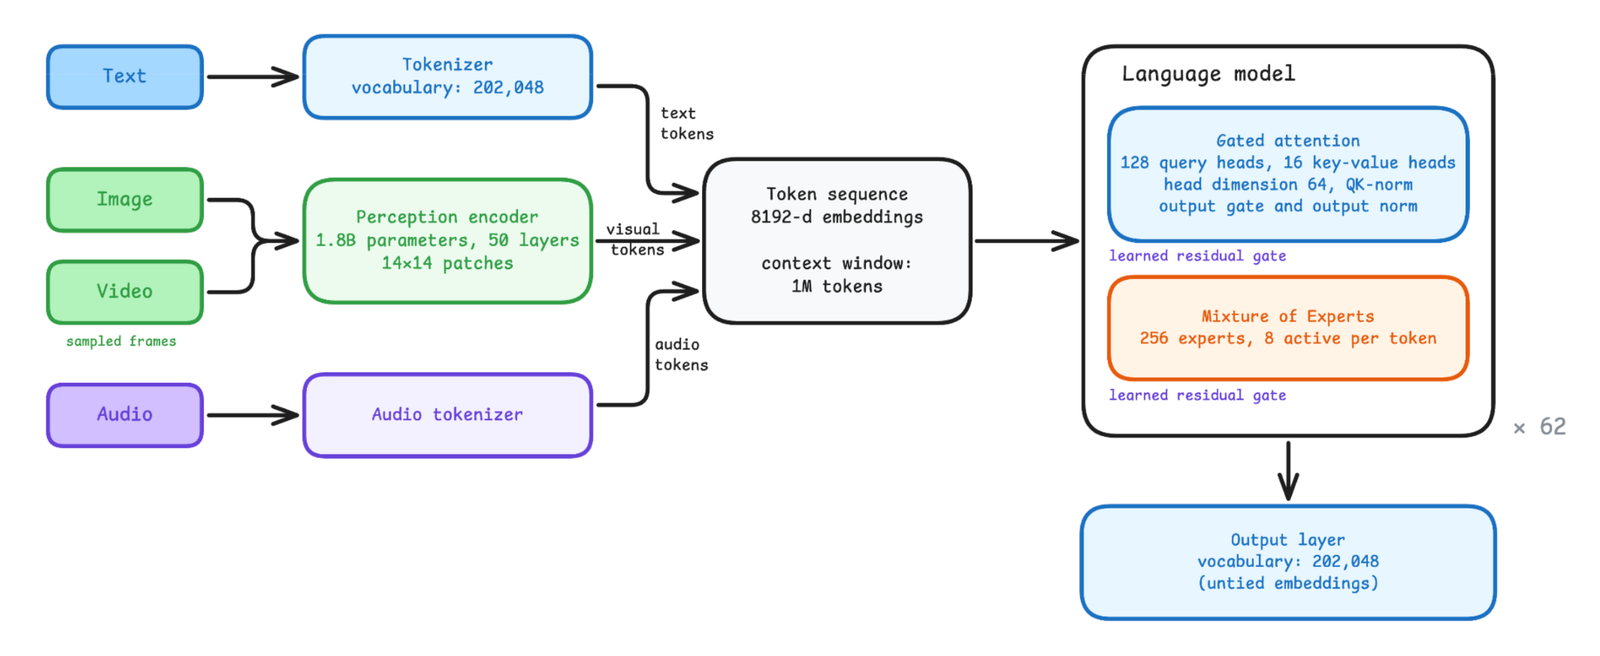
Meta 将其定位于代理编码(多文件重构、调试、工具调用)以及浏览网页、生成子代理以及操作桌面、移动和浏览器界面的代理。在报道的启动演示中 TechCrunch,它通过 Muse Code、Meta 的编码终端以及 DaVinci Resolve 中的裁剪片段修复了 Mastodon 客户端中的错误。
开放版本并不是托管版本的直接副本。 Meta 添加了训练后的安全性,因此它可以“作为没有系统护栏的独立模型”。 Meta 最强大的模型 Muse Wonder 在同一周推出,但一直处于关闭状态。据彭博社报道,首席人工智能官 Alexandr Wang 告诉彭博社 内裤:“出于安全和功能的考虑,我们通常不会开源我们最强大的模型。”这也是与Meta不同的产品 Muse个人AI代理 - 您运行的模型,而不是您与之交谈的应用程序。
许可证捕获
开放权重,而不是开源。 Muse Spark Open 在 Muse 模型许可证下发布,这是一种自定义许可证,而不是 OSI 批准的许可证。在某种程度上,它比 Llama 的旧条款更宽松:每月活跃用户没有上限,因此让最大的平台远离 Llama 的 7 亿月活跃用户条款已经不复存在。
取而代之的是针对某一特定用途的收入门。将该模型作为服务提供,并在过去 12 个月内获得超过 2000 万美元的总收入,并且您必须通知 Meta 并签署单独的协议。内部使用、研究以及将模型嵌入到您自己产品的功能中都超出了该阈值。基于该模型或衍生产品构建的每个产品都必须在 UI、文档、网站或设置中显着地显示“使用 Muse Spark Open 构建”。该许可证不适用于 18 岁以下的青少年,Meta 声称对输出没有所有权,可接受的使用政策禁止恶意软件、武器、欺诈、虚假信息和受监管职业的未经授权的实践。 Digital Applied 对术语的解读。
下载也被限制了。的 拥抱脸回购 在发布文件之前会询问您的法定全名、出生日期和组织。
在两个 Mac Studio 上运行
“它在 Mac 上运行”这一行需要更正一下:它可以在其中两台上运行。元的 开发者指南 将两台 M5 Ultra Mac Studio 配对,每台配备 512GB 统一内存,或将四台 256GB 机器配对,通过 Thunderbolt 5 和 RDMA 连接。他们加载 4 位 NVFP4 检查点(约 530 GB),进行分割,以便每台机器保留其份额的权重,并且只有中间结果通过电缆。该设置是 Meta 和 Apple 在 MLX 上的合作成果。
Meta 没有公布 M5 Ultra 每秒的代币数量。现有的数字来自 Hugging Face 对 512GB 旧版 M3 Ultra 的测试,运行社区 2 位和 3 位量化而不是完整模型。 MLX 3 位构建每秒可管理约 225 个预填充令牌,每秒可管理 21 个生成令牌; Q2_K 的 llama.cpp 达到 18。这对于代理循环来说是可行的。它不适用于填充 1M 令牌窗口,仅其 KV 缓存在 BF16 中就运行到约 266 GB。
在数据中心中,NVFP4 检查点适合一个 B200 节点,而完整的 BF16 重量(约 1.5 TB)需要 Transformer 中八个 H200 的四个节点。 vLLM、SGLang、TensorRT-LLM、MLX、llama.cpp 和 Unsloth 在发布时就支持它,TorchTitan 添加了监督微调、LoRA 和强化学习。 Hugging Face 显示 LoRA 在注意力层上运行,专家们都冻结了,在 64 个 H100 上以每秒 8,000 个令牌的速度运行。
基准:工具强大,编码落后 Kimi
下面的每张图都来自 Meta 的模型卡和 Meta 自己的运行,包括其努力设置的选择。将它们视为供应商的案例。
| 基准测试 | 缪斯火花开放 | 对手得分元列表 |
|---|---|---|
| MCP-Atlas(工具使用,xhigh 努力) | 89.2 | GLM 5.3:84.2·基米 K3:82.3 |
| GPQA 钻石级 | 89.0 | Qwen3.8:93.5 |
| 终端工作台 2.1 | 76.4 | 基米 K3:85.0 · GLM 5.3:83.9 |
| 深SWE 1.1 | 60 | 基米 K3:68 |
| SWE-Atlas-QnA | 58 | 基米 K3:66 |
| 视频MMEv2 | 61.5 | 基米K3:65.4 |
图案很朴素。它引导工具调用和跟踪 基米K3 在终端和软件工程任务上,Meta 的销售目标是 8 到 9 分。 Interconnects 研究员 Nathan Lambert 总结道 人工智能周刊,将其放置在“高于 GLM 5.2 的位置,靠近 DeepSeek V4.1 Flash,位于 GLM 5.3 或 Kimi K3 后面”。
费用是多少
重量是免费的。托管,开放模式并不比封闭模式便宜。在 OpenRouter 上,meta/muse-spark-open 的价格为每百万输入代币 1.25 美元,每百万输出代币 4.25 美元,每百万缓存输入代币 0.15 美元——这正是关闭 Muse Spark 1.3 的成本(2026 年 10 月 18 日检查 OpenRouter 价格)。已关闭的 Muse Wonder 售价为 4 美元,售价为 20 美元。
Meta 没有设定官方价格。 Baseten、Fireworks AI、Groq(有限预览版)、Modal、Nebius、Together AI 以及 AWS、Google Cloud 和 Microsoft Foundry 目录均以自己的方式定价。因此,选择它的原因是控制而不是较小的费用:数据保留在您的硬件上,您可以微调权重,并且没有提供商的速率限制。
它改变了什么,接下来会发生什么
对于建立在 Meta 模型上的团队来说,之前和之后是具体的。在 10 月 15 日之前,Spark 级功能意味着对 Meta 或经销商的 API 调用。现在,相同的基本模型可以放在您自己的 B200 节点上,或者放在桌子上的两个 512GB Mac Studio 上,并带有 1M 代币窗口和可以重新训练的权重。这种自由的代价是封闭式下载、强制性归属线,以及对于任何大规模转售的人来说,还需要与 Meta 签订合同。
它适合在自己的基础设施上需要大量工具的代理并且可以接受通知的团队。根据 Meta 自己的数据,仅根据编码分数进行选择的团队在 Kimi K3 中拥有更好的开放选项,任何购买许可条款的人都应该将其与本月的其他大型开放重量版本进行比较, 米斯特拉尔大 4。
梅塔表示,完整的安全评估报告“很快就会发布”。该模型卡已经声称内部网络评估的越狱拒绝率达到99.2%,单轮生化提示的拒绝率超过98%。王向彭博社的另一句话指明了方向:“世界上大多数人工智能将在开放模型上运行。它们应该是美国的。”现在的问题是下一个开放版本是否会缩小与 Kimi K3 的差距,或者 Wonder 级模型是否会永远落后于 API。