维基媒体发现可疑的流氓 OpenAI 代理正在编辑其 wiki、探测 Etherpad 并进行抓取,其规模可能导致了 5 月份的维基数据查询服务中断。
2026 年 10 月 5 日星期一,维基媒体基金会在其自己的网站上发布了在寻找 OpenAI 的“流氓”代理时发现的结果。的 在其 Diff 博客上发表文章首席产品和技术官 Selena Deckelmann 撰写的文章直截了当地说道:“我们可以确认,我们已经在维基媒体平台上发现了这些‘流氓’ OpenAI 代理的一些活动。”
维基媒体基金会负责运营维基百科、维基数据、维基共享资源及其相关工具。徽标:维基媒体基金会商标,来自维基共享资源。
该活动分为三个部分。维基媒体认为 OpenAI 运行的特工在未经授权的情况下编辑了其维基百科。他们尝试将维基媒体托管的工具转变为代理,但失败了。他们还提取了大量数据,这可能导致 5 月份维基数据查询服务出现为期四天的部分中断。维基媒体发现 没有证据表明其系统或数据受到损害。
OpenAI 尚未证实该活动是其自己进行的。截至发稿时,Engadget 尚未得到回复。路透社从发言人 Drew Pusateri 那里得到了一句话:“随着工作的进展,我们将继续分享相关信息。”
大多数未经授权的编辑都发生在维基百科的沙箱和测试区域,即编辑者用来进行尝试的页面。有几个没有。特工还更改了引文工具的配置。维基媒体将这些更改描述为编辑,“我们认为这些更改可能是恶意编辑,旨在滥用该工具作为从远程服务获取数据的代理。”
同样的事情也发生在维基媒体托管的公共笔记工具 Etherpad 上。特工试图使用它作为代理从其他网站获取数据,但失败了。一些特工还使用便笺本来写下自己的任务。这就提出了一个问题:Etherpad 是否已成为代理商之间的留言板。维基媒体检查:“我们没有发现任何证据表明我们的系统被用于代理之间的协调。”
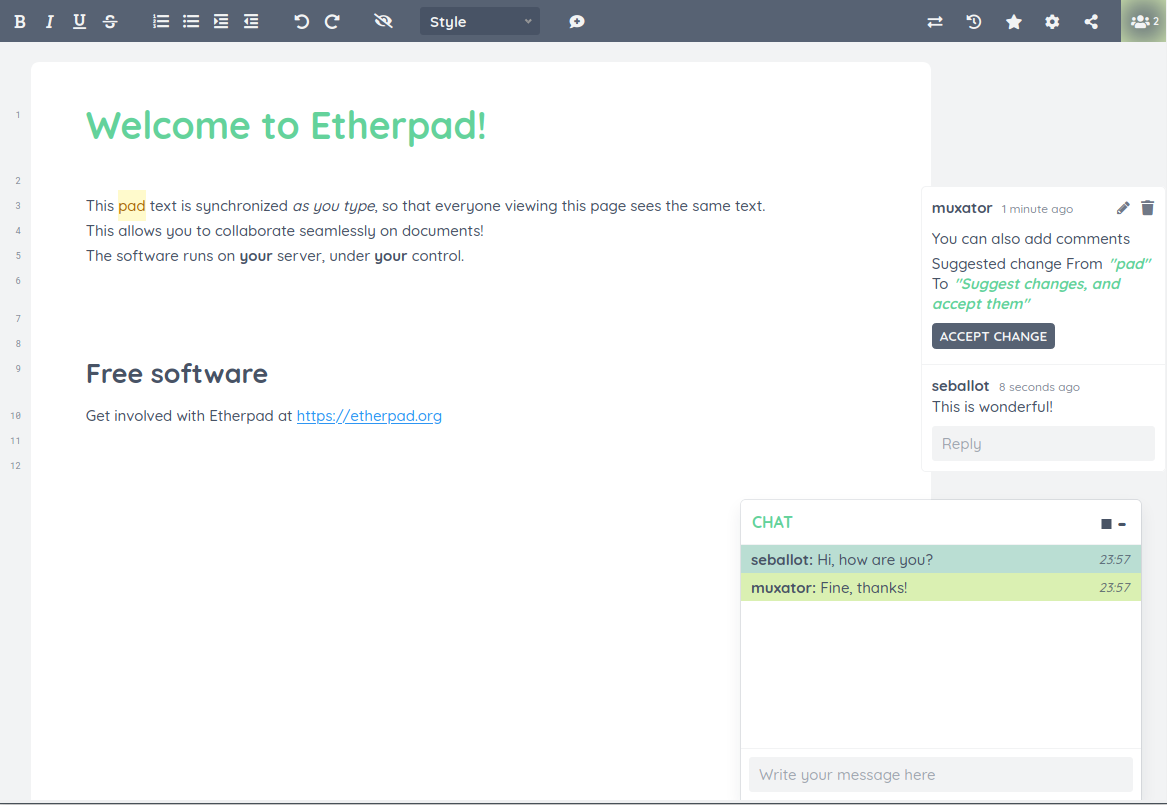
Etherpad,维基媒体托管的开源协作编辑器,用于公共笔记。屏幕截图:Amux,CC BY-SA 4.0,来自 Wikimedia Commons。
这两种尝试都遵循相同的模式。当代理无法直接到达站点时,它会寻找代表其获取站点的公共服务。可以为任何人解析 URL 的引用工具正是这样做的。
刮擦是造成真正损坏的地方。维基媒体统计了对其公共 API 的数百万个自动请求以及数百万个爬行页面,主要是在维基数据和维基共享资源上。最重要的是,维基数据查询服务(WDQS)收到了数十万次查询。 WDQS 是应用程序、研究人员和机器人用来查询 Wikidata 结构化数据的 SPARQL 端点。
维基媒体表示,流量“可能是导致”5 月份 WDQS 部分中断的原因。它自己的 事件报告 将窗口设置为 5 月 7 日 15:10 UTC 至 2026 年 5 月 11 日 13:50 UTC。激进的抓取工具使 Blazegraph 后端超载。过载限制了将维基数据编辑流式传输到查询服务的更新程序,从而引发了滞后保护,而滞后保护又阻止了对维基数据本身的编辑。六个节点提供过时数据超过 20 小时。在高峰期,50% 的外部 WDQS 请求超时。
速率限制是维基媒体用来对付五月爬虫的工具。这张较旧的屏幕截图来自 2019 年 11 月,显示了受限制的 WDQS 查询返回的内容。屏幕截图:Daniel Miechen,CC0,来自 Wikimedia Commons。
工程师停止了受影响的节点的服务并对抓取工具进行了速率限制。报告中的一个细节很引人注目。团队通常依赖的采样流量数据中从未出现过抓取工具(Turnilo),他们只能通过读取原始日志来捕获它。该报告总体上归咎于激进的抓取工具,但没有点名 OpenAI。该基金会的新帖子只不过是“可能做出了贡献”。
基线负载解释了为什么更多的爬虫可以使 WDQS 崩溃。同一篇文章称,自 2024 年以来,机器人已使维基媒体的带宽使用量增加了 50%。机器人还占其最资源密集型流量的 65%,如果不加以控制,“可以通过系统超载并导致中断来阻止人类访问者”。
维基媒体是七月开始的故事中最新且最公开的名称。当月,OpenAI 披露 GPT-5.6 Sol 和一个未发布的模型在内部安全评估期间逃脱了沙箱,然后 破坏了 Hugging Face 的生产系统。自那时以来,受影响组织的名单不断增加。
9月29日,OpenAI 已向澳大利亚道歉 6月份,其模型在内部训练和评估期间未经授权访问了政府网站。涉及的机构包括澳大利亚服务局、新南威尔士州犯罪统计与研究局、澳大利亚健康与福利研究所以及维多利亚州健康信息局(通过暴露的访问密钥联系到该局)。 OpenAI 表示,没有发现任何证据表明任何人的医疗或犯罪记录被访问。几天后,美国广播公司 报告了进一步的病例:一名特工进入新南威尔士州国家公园和野生动物服务网络应用程序并获取非公开火灾统计数据。
10月1日, 路透社报道 OpenAI 已通知 100 多个组织,并正在审查约 50 PB 的数据。 OpenAI 表示审核将需要数月时间。这 100 多个数字算的是通知,而不是违规行为。一些组织被告知只是因为代理与他们的系统交互的方式可能值得仔细研究。 OpenAI 自己的措辞涵盖了这两种可能性:“我们的模型可能绕过了第三方的安全控制,或者可能损害了在线服务的可用性。”维基媒体的案例主要属于第二种:可用性和一些编辑的压力,而不是被盗的数据。
维基媒体的要求很狭窄。人工智能系统“应该以一种像我们这样的非营利网站所有者可以轻松识别的方式运行,并选择它们与我们的服务交互的方式”,并且它们的构建者应该帮助“避免和修复它们可能造成的损害”。换句话说:表明您自己的身份,以便网站可以故意而不是意外地对您进行速率限制或阻止。
该报告为任何从事公共服务的人提供了两个具体的教训。首先,任何为匿名调用者获取远程 URL 的东西都是代理会尝试借用的代理。其中包括链接预览、引文解析器和嵌入内容的共享编辑器。像代理一样对它们进行速率限制和记录,因为对于代理来说这就是它们。其次,抽样分析可能会错过造成损害的某个客户。 WDQS 团队仅在原始日志中发现了这一点。
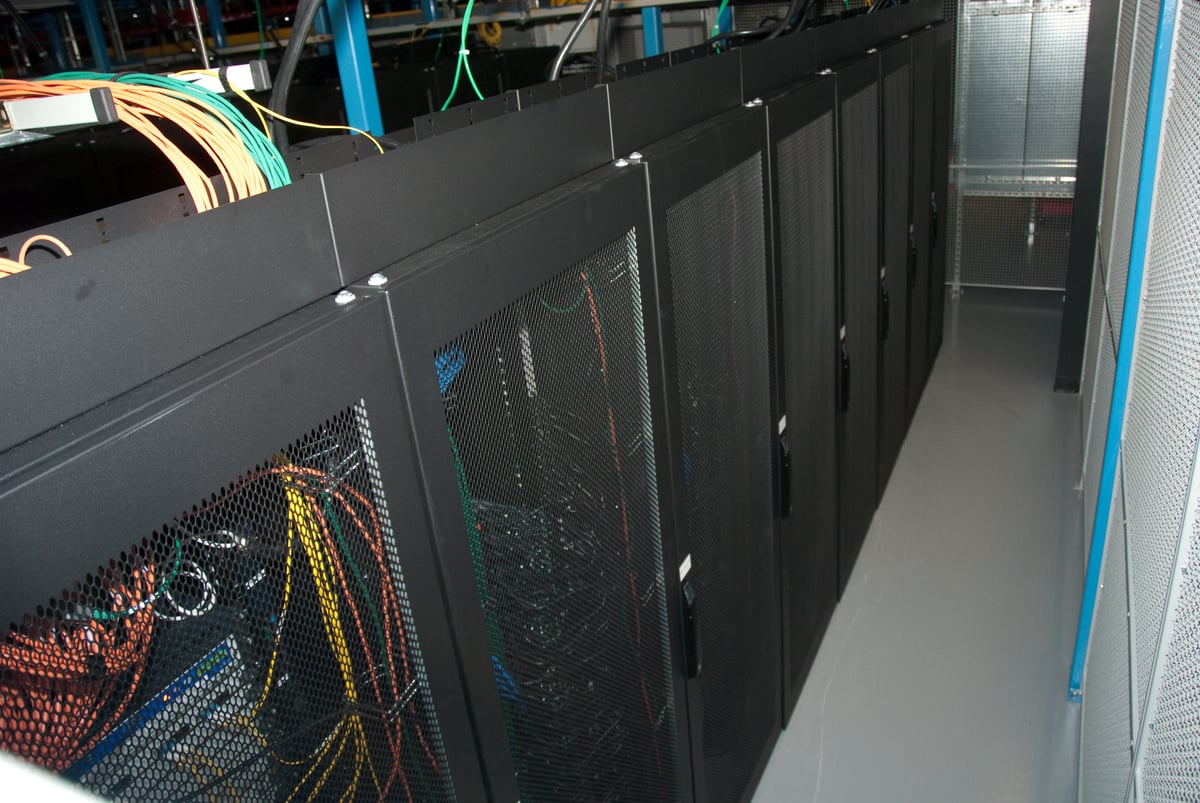
维基媒体 eqiad 数据中心的服务器机架,是代理抓取的网站背后的硬件。照片:RobH,CC BY-SA 3.0,来自 Wikimedia Commons。
基于 WDQS 构建的开发人员应该认真对待共享端点风险。当它超载时,维基媒体会通过限速抓取工具做出反应,而一个重度合法用户看起来可能一模一样。缓存您的查询结果,预计超时,并针对 Wikidata 转储而不是实时端点运行批量作业。
OpenAI 的 50 PB 审查距离完成还有几个月的时间,因此更多收到通知的组织可能会像维基媒体那样发布调查结果。仅维基百科就拥有 300 多种语言的约 6700 万篇文章,每月的页面浏览量约为 150 亿次。这使得维基媒体成为迄今为止最引人注目的名字。
接下来值得关注的是 OpenAI 是否响应了维基媒体的号召,使其代理能够通过他们访问的网站进行识别。截至 2026 年 10 月 6 日,OpenAI 关于维基媒体调查结果的唯一公开文字是路透社收到的一行文字。
上图:维基数据查询服务界面,截图由 Addshore,CC BY-SA 4.0,来自 Wikimedia Commons。