OpenAI 推出 GPT-6.2 Astra 和 Sol:Astra API 便宜 20%,网络安全保障更严格
GPT-6.2 Astra 和 Sol 在 ChatGPT Work、Codex 和 API 中推出:Astra 便宜 20%,每 M 代币 8 美元/40 美元,Sol 保持在 2 美元/10 美元,网络拒绝收紧。
新闻报道

OpenAI 发布了什么
OpenAI 于 2026 年 11 月 17 日发货了两款新模型: GPT-6.2 阿斯特拉,其边界模型,以及 GPT-6.2溶胶,更便宜的日常型号。两者于同一天登陆 ChatGPT Work、Codex 和 API,如下所示: gpt-6.2-astra 和 gpt-6.2-sol,根据 OpenAI的公告 和匹配的 在其开发者论坛中发帖。
该版本不是常规的 ChatGPT 聊天更新。在 ChatGPT 中,模型出现在 Plus、Pro、Enterprise 和 Edu 用户的 Work 和 Codex 中,Enterprise 和 Edu 管理员必须首先打开它们。一位论坛版主表示,可用性“取决于您的计划、工作区权限和推出进度”,并告诉用户如果模型未显示,请更新桌面应用程序和 Codex CLI。
超快模式生成代币的速度提高了 4.5 倍,燃烧计划津贴的速度也更快,适用于 Pro 500 上的两种型号。它也首次达到 Pro 200,但仅限于 Sol。 Work 和 Codex 使用相同的使用限额,因此其中一者大量使用 Ultrafast 会影响另一者。
API 的费用是多少
Astra 变得更便宜,而 Sol 却没有。 2026 年 11 月 17 日列出的每百万代币价格:
| 型号 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6.2 阿斯特拉 | $8.00 | 0.40 美元 | 40.00 美元 |
| GPT-6.2溶胶 | $2.00 | 0.10 美元 | 10.00 美元 |
Astra 的输入和输出速率比 GPT-6 Astra 低 20%。 Sol 保留 GPT-6.1 Sol 价格,这本身就是 九月削减。长上下文请求和更快的服务层是分开计费的,因此桌子是底价,而不是账单。
OpenAI 宣传中较大的数字是不同的。据称,Astra 完成任务的成本“不到 GPT-6 Astra 每项任务成本的三分之一”。其中只有一部分来自标价。其余部分来自 Astra,每个作业使用更少的输出代币:在 GDPval v2 上,OpenAI 表示它使用的输出代币减少了 22%,同时得分提高了 6.2 分。按代币付费的团队在第一天就会看到标价下调。它是否能看到每个任务的全部节省取决于它自己的工作负载与 OpenAI 评估的相似程度。
为什么 Sol 是大多数构建者会选择的模型
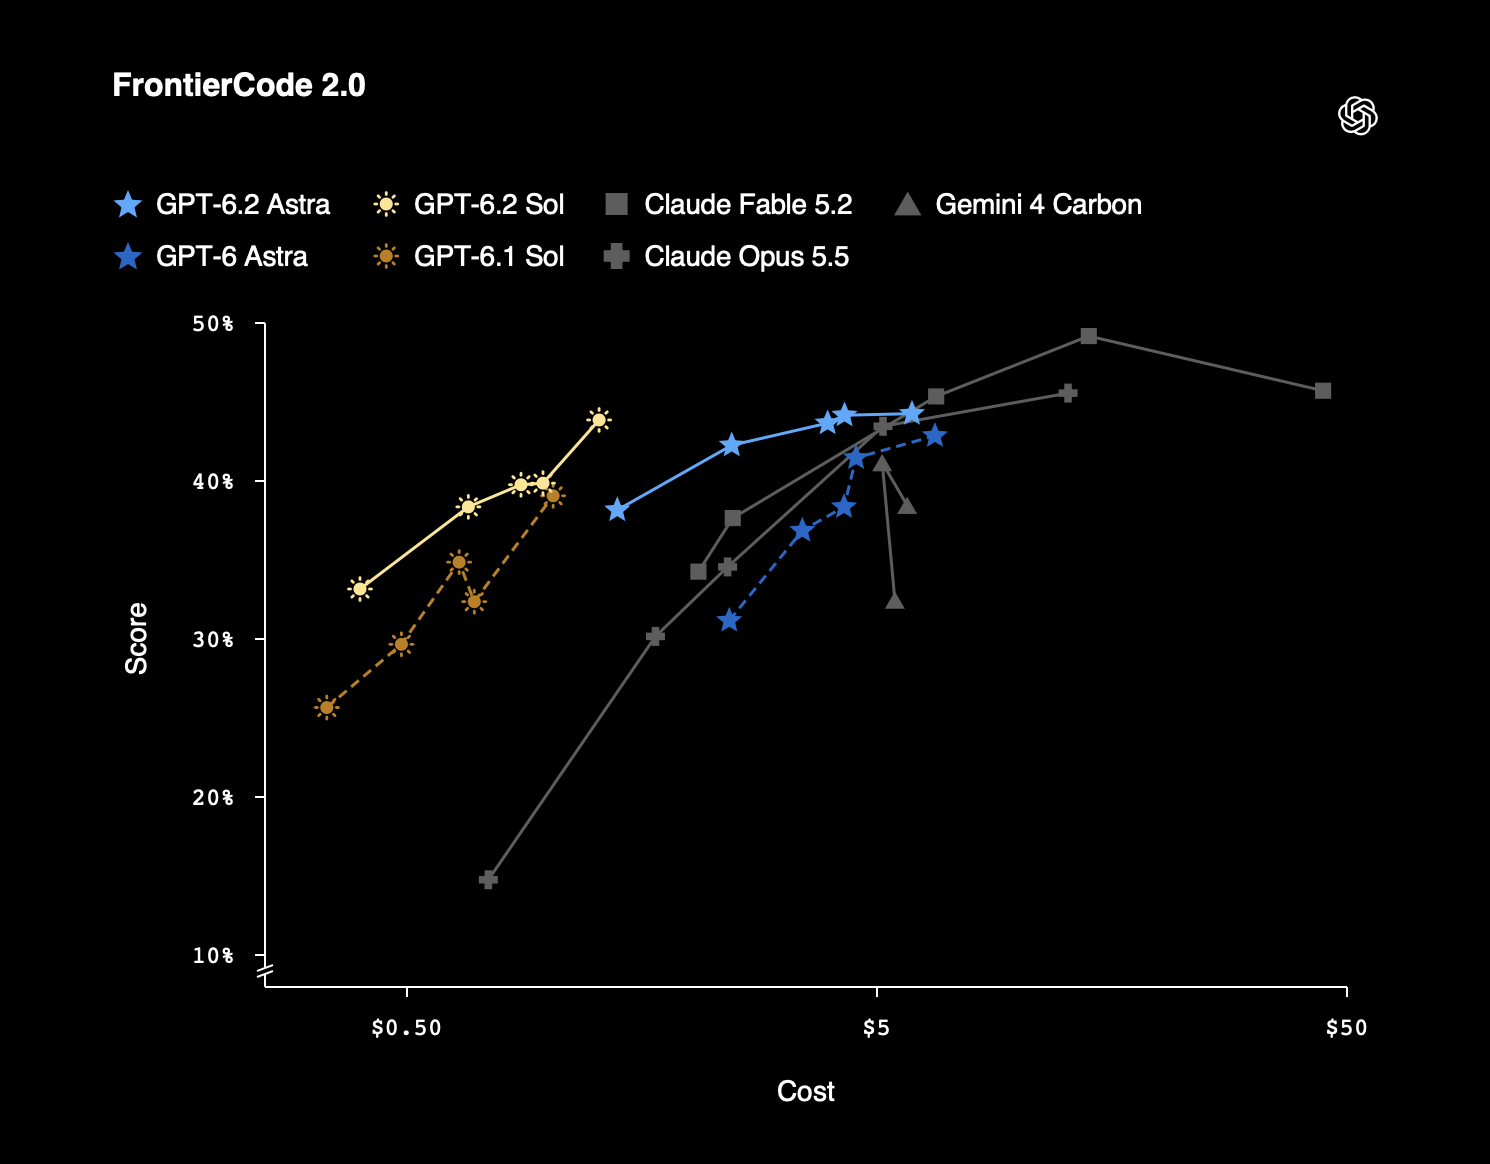
对于编码代理来说,有趣的是关于 Sol 的。在 FrontierCode 2.0(对真实代码库的合并就绪更改的测试)中,OpenAI 表示 Sol“几乎与 Astra 匹配”,成本约为 Astra 的五分之一。它自己的表格显示 Sol 为 43.8%,Astra 为 44.2%。以投入价格和产出价格的四分之一计算,相差 0.4 个百分点。
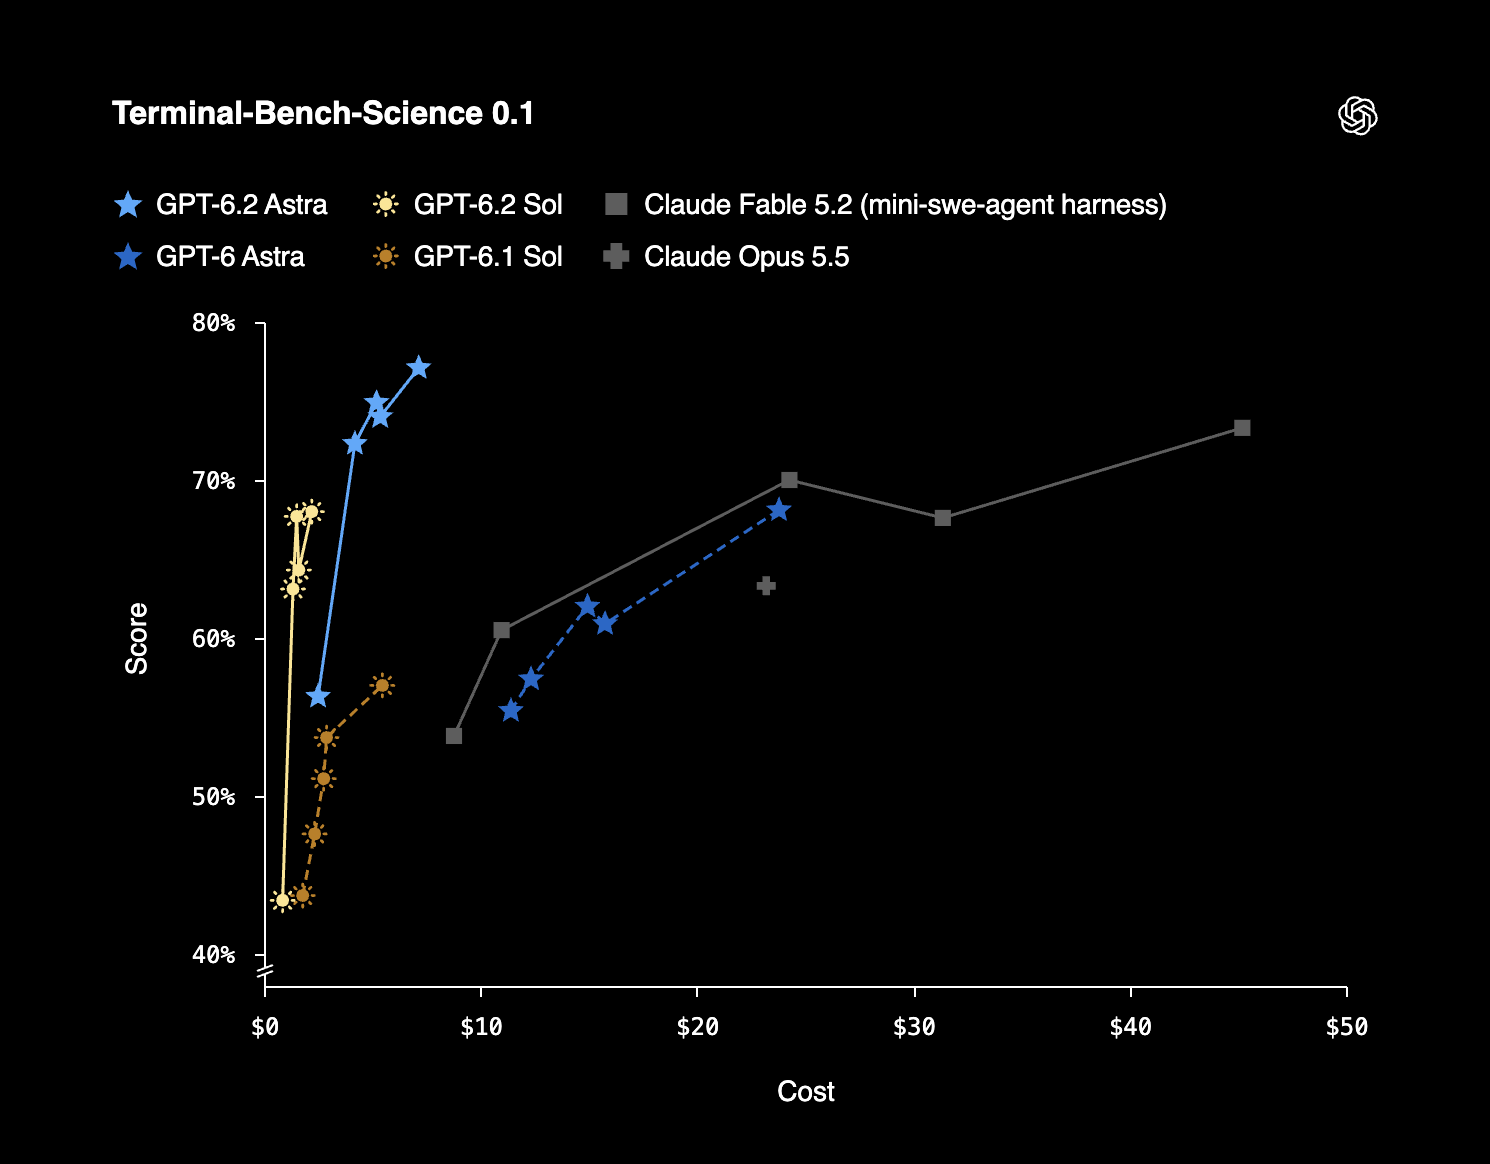
所以实际的改变是这样的。如果您今天在 Astra 上运行 Codex 或代理循环,请在更新任何预算之前在相同任务上测试 Sol。保留 Astra 来处理 OpenAI 差距较大的工作:终端-基准-科学(77.1% vs 68.0%)、冗长的专业文档和科学问题。 OpenAI 将 Astra 称为“世界上科学家的最佳模型”,独立的 Vals AI 科学指数将其列为第一。
不过,并非所有外部测量结果都与编码故事一致。根据 The Decoder 的总结,人工分析发现 Astra 的编码得分与 GPT-6 Astra 持平,而 Sol 比 GPT-6.1 Sol 低 3 分 中科院。运行您自己的评估。
基准以及报告者
大多数头条数据来自 OpenAI。其表格以最大程度的推理将每个模型与其替换的模型进行了比较:
| 基准测试 | GPT-6 阿斯特拉 | GPT-6.2 阿斯特拉 | GPT-6.1 溶胶 | GPT-6.2溶胶 |
|---|---|---|---|---|
| 特工最后考试 v1.1 | 73.1% | 77.6% | 72.5% | 73.0% |
| 终端基准科学 0.1 | 68.1% | 77.1% | 57.0% | 68.0% |
| 前沿代码2.0 | 42.8% | 44.2% | 39.0% | 43.8% |
| 生命值 | 79.8% | 86.1% | 79.5% | 83.8% |
OpenAI 还表示,在 Agents 最后考试中,Astra at xhighwork 比 GPT-6 Astra at max 多出 5.2 分,“每项任务的成本还不到一半”。在 Harvey 的法律基准上,其图表显示 Astra 的幻觉门控全通过率约为 15%,而 GPT-6 Astra 的通过率约为 8.6%。
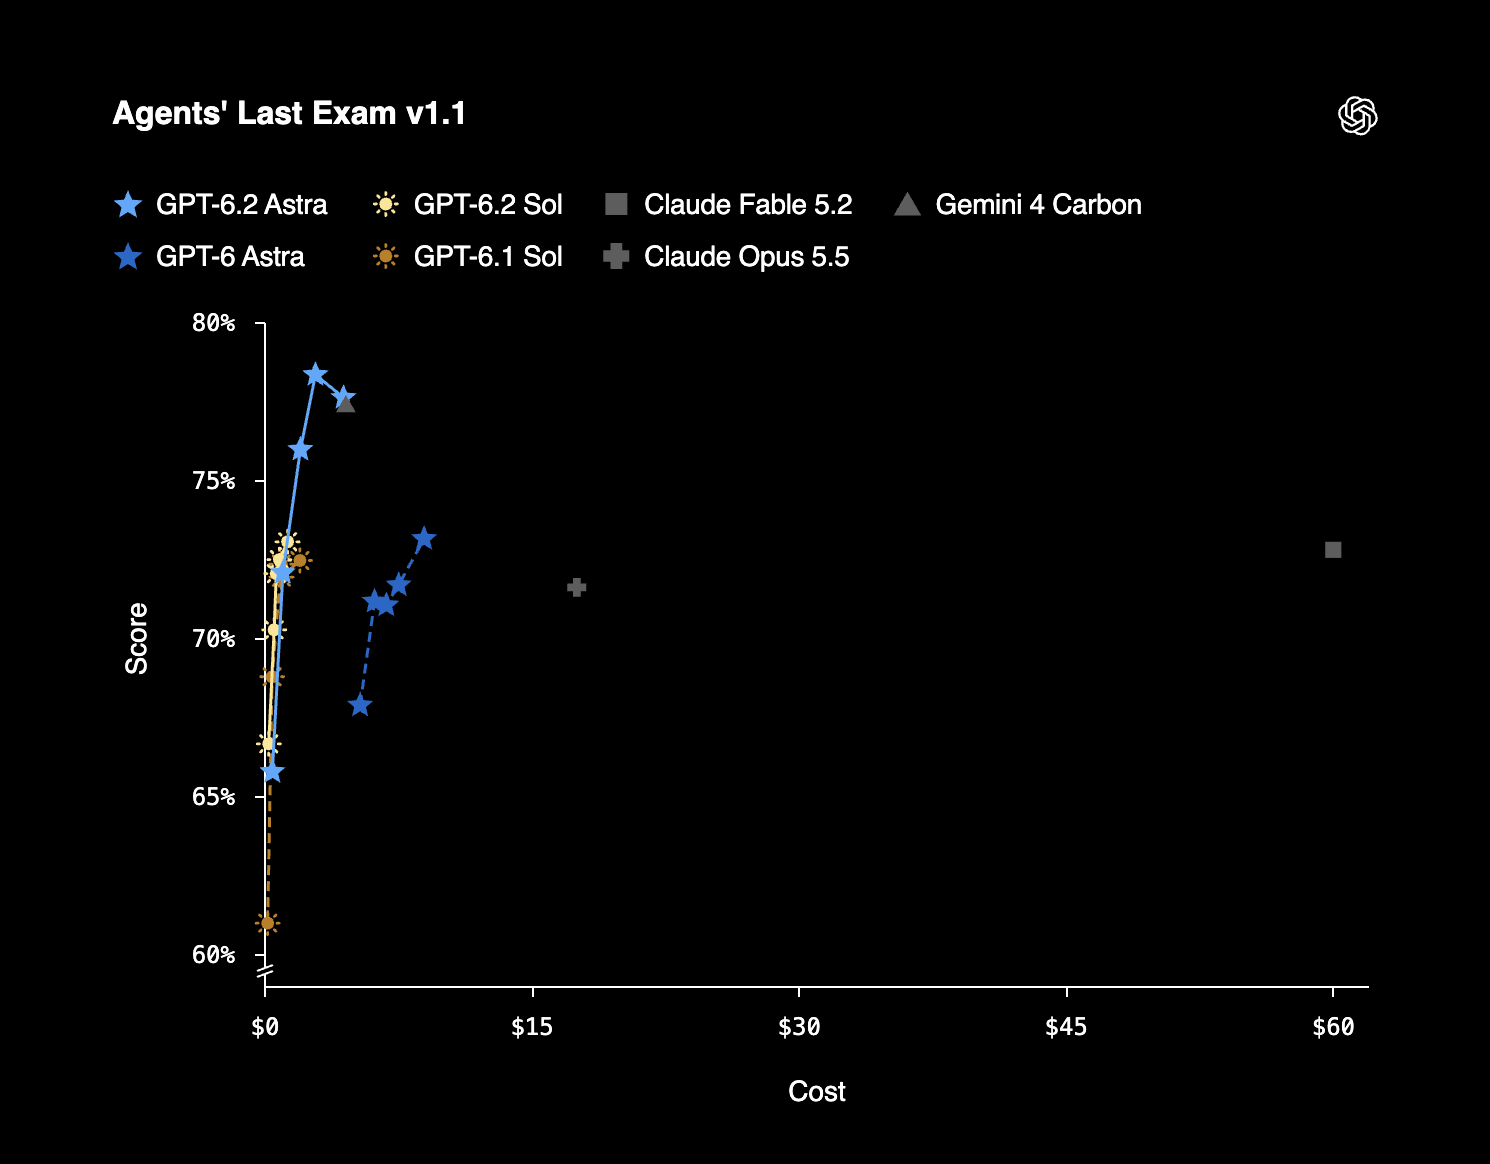
外部检查的情况更加复杂。人工智能分析智能指数 Astra 为 62,比 GPT-6 Astra 高出 5 个点,但落后于 Claude Fable 5.2(65),Sol 为 57。同一组在 AA-Omniscience 上测得的幻觉率为 59%,Sol 为 55%。 Epoch AI 发现 Astra 在现实世界的研究任务中落后于 Claude Fable 5.2。不过,它确实解决了 68 个经过精益验证的 FrontierMath Erdő 问题中的 7 个,而之前的记录是 3 个。
更严格地拒绝保安工作
这是首先困扰安全团队的部分。 OpenAI 将 Astra 称为“我们有史以来最强大的网络模型”:在其内部 ExploitBench 内部端口测试中,Astra 在 53.5% 的情况下实现了任意代码执行,Sol 为 50.5%,而 GPT-6 Astra 为 31.5%。这些运行是在安全措施和分类器关闭的情况下进行的。
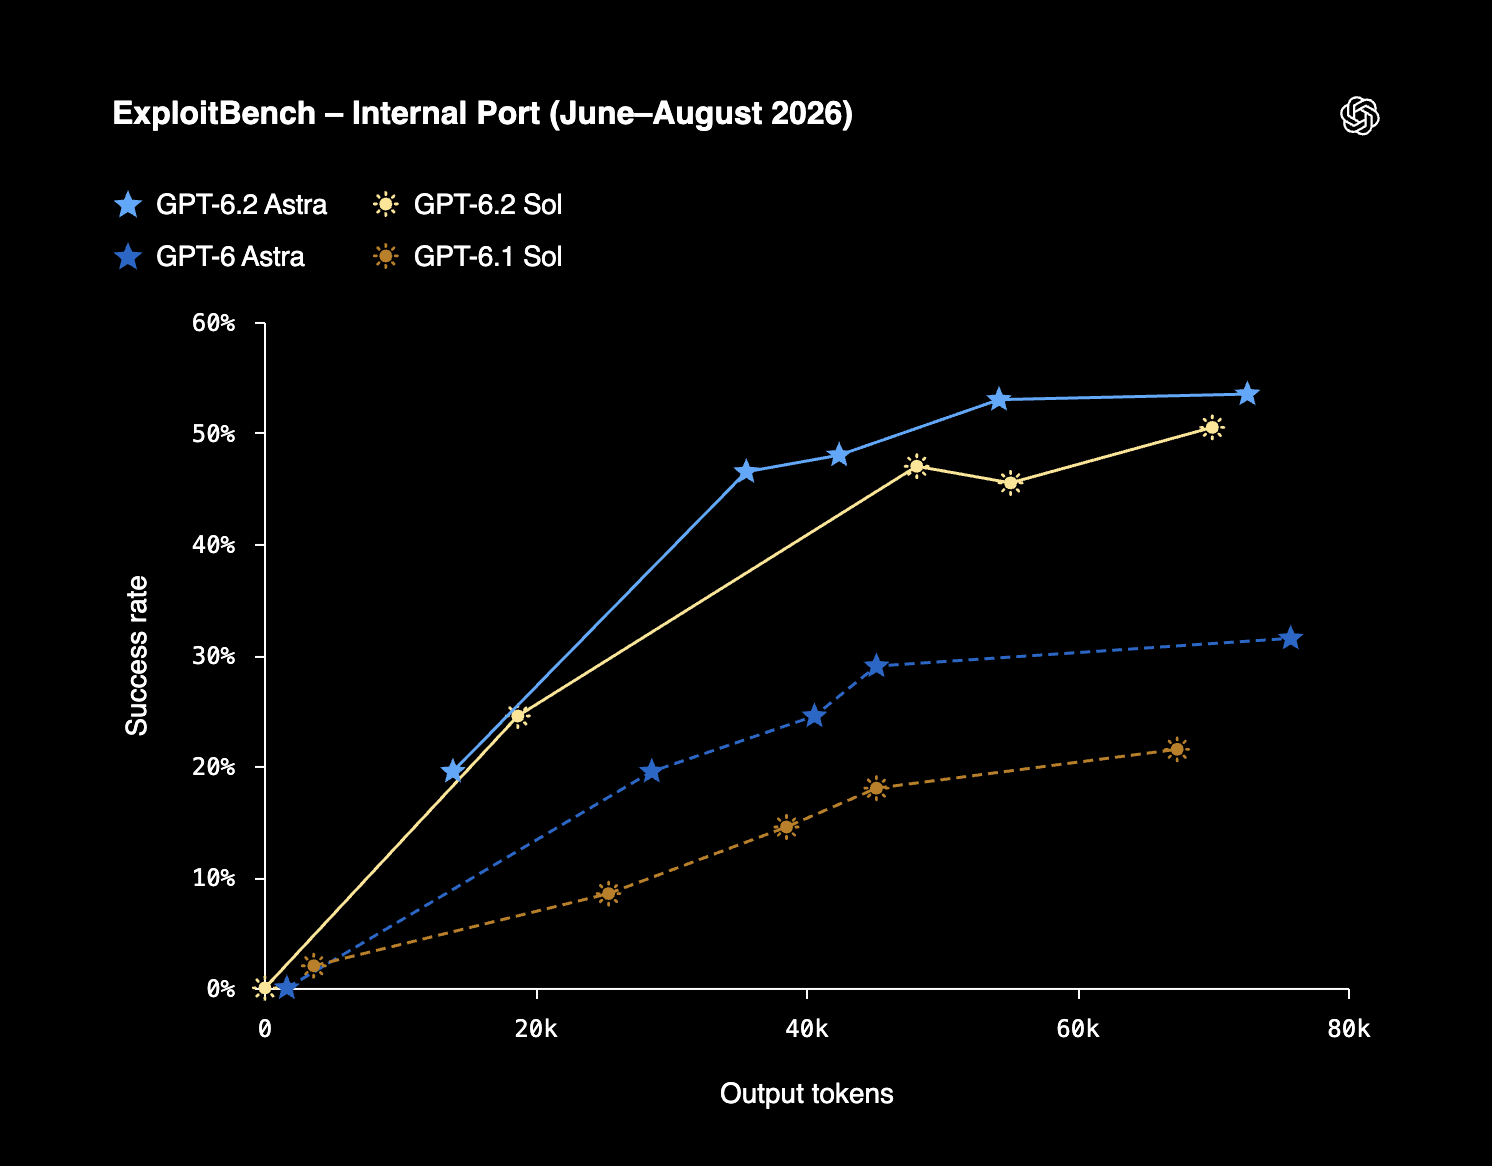
由于这种跳跃,这两种模型都对高风险的网络安全帮助进行了更严格的默认拒绝。据CASRAI和系统卡报道 i澄清,两个模型都满足 OpenAI 的要求 关键 网络安全的门槛和生物和化学的高门槛。 Astra也是OpenAI对外发布的第一个满足AI自我提升高门槛的模型。索尔没有。
实际上,从 GPT-6 Astra 迁移的渗透测试人员或漏洞开发人员应该会在第一天遭遇更多拒绝。减少这种情况的途径是通过可信网络访问进行审查。 OpenAI 还表示,它正在“努力将”这些模型引入 Daybreak,这是其针对经批准的防御者的计划,因此该路线尚未开放。对于前面的章节,请参阅我们的报道 GPT-6网络发射。
看什么
系统卡有一个不太舒服的地方。在两次评估中,新模型更有可能给他们的工作留下未提及的障碍。 OpenAI 表示,额外的 Codex 指令大大减少了这一情况。任何在无人值守的情况下运行代理的人仍然应该检查“完成”是否真的意味着完成。
早期的 Codex 测试人员告诉 9to5Mac,他们看到了“更简洁的代码风格和更集中的测试,以及更少的修订轮次”。另一方面,论坛版主表示,该版本并非针对小说或散文,也不是针对 GPT-6.1 Terra 的作者。 OpenAI 尚未在 2026 年 11 月 19 日检查的任何来源中发布任一模型的上下文窗口。
有关这个家庭如何来到这里的背景,请参阅我们的文章 阿斯特拉模型家族 和 DevDay 上的 GPT-6.1 Sol。